یادگیری ماشین (Machine Learning) چیست؟
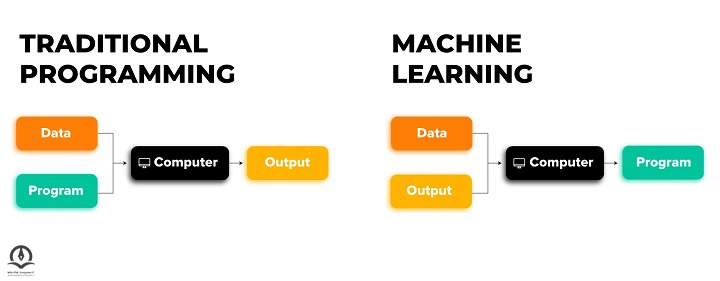
یادگیری ماشین (Machine Learning) یکی از زیرشاخههای هوش مصنوعی است. علم ماشین لرنینگ یا یادگیری ماشین با استفاده از الگوریتمهای مناسب، به کشف روابط و الگوهای بین اطلاعات ما میپردازد. در واقع، پیش از فراگیری یادگیری ماشین، برنامهنویسان با نوشتن توابع، ورودی را به برنامه داده و خروجی خود را دریافت میکردند. اما امروزه به لطف الگوریتم های یادگیری ماشین، میتوانیم ورودی و خروجی مربوط به آن را به الگوریتم یادگیری ماشین بدهیم و سپس ماشین الگوهای موجود بین آنها را یاد بگیرد. برای آشنایی بیشتر، مقاله یادگیری ماشین چیست را مطالعه فرمایید.
انواع یادگیری ماشین
یادگیری ماشین بر مبنای چهار نوع زیر است:
- یادگیری نظارتی
- یادگیری غیر نظارتی
- یادگیری نیمه نظارتی
- یادگیری تقویتی
یادگیری نظارتی (Supervised Learning)
یکی از پرکاربردترین روشهای یادگیری ماشین است. ماشین تلاش میکند با استفاده از مجموعه دادهای که در اختیار آن قرار دادهایم یاد بگیرد و بتواند بر اساس آنها موارد دیگر را حدس بزند. در واقع ماشین X را به عنوان ورودی دریافت میکند و بر اساس الگوهای بین X و Y های پیشین که بهدست آمده است، Y را به عنوان خروجی برای ما پیشبینی میکند.
- دسته بندی (Classification): خروجی این مسائل، دستهای از پاسخهای ممکن است؛ مثلا پاسخ، درست یا نادرست است یا این که پاسخ میتواند بیشتر از دو حالت داشته باشد. سیستم تشخیص هرزنامه ایمیل یک یادگیری نظارتی از نوع دستهبندی است.
- رگرسیون (Regression): خروجی این مسائل، عددی حقیقی است. مثلا ورودی ماشین شرایط و ویژگیهای یک کالا باشد و در خروجی پیشبینی قیمت آن کالا را داشته باشیم، میتواند مثالی برای مسائل رگرسیون باشد.
یادگیری غیر نظارتی (Unsupervised Learning)
در این شیوه یادگیری، برای استفاده از الگوریتمهای یادگیری ماشین مربوط به آن، فقط از متغیر X استفاده میشود. به بیان دیگر، مجموعه داده مورد استفاده ما بدون برچسب (Y) هستند، در نتیجه، پاسخ صحیحی نداریم و خود ماشین باید الگوها و روابط مهم را استخراج کند. یادگیری غیرنظارتی قابل تقسیمبندی به صورت زیر است:
- خوشه بندی (Clustering):این مسائل مربوط به زمانی هستند که بخواهیم دستههای مختلفی براساس ویژگیهای مشترک دادهها در دیتاست خود پیدا کنیم. گروهبندی مشتریان یک بانک براساس تراکنشهای بانکی آنها میتواند یک مسئله خوشهبندی حساب شود.
- انجمنی (Association): خروجی این مسائل، قواعد انجمنی هستند که براساس روابط بین دادهها بهدست میآیند و به صورت یک جمله شرطی با ساختار "اگر - آنگاه" است؛ مثلا، اگر مشتری تخم مرغ بخرد، آنگاه ممکن است شیر هم بخرد.
یادگیری نیمه نظارتی (Semi-Supervised Learning)
یادگیری نیمه نظارتی از ترکیب دو روش یادگیری گفته شده در بالا به وجود آمده است. مجموعه دادهای که این دست از مسائل بر روی آنها کار میکنند، از دو بخش دیتاهای دارای برچسب و دیتاهای بدون برچسب تشکیل شده است. در این روش ابتدا با بخش برچسب دار یادگیری نظارتی انجام میشود و سپس یادگیری غیرنظارتی با بخش بدون برچسب دیتاها رخ میدهد.
یادگیری تقویتی (Reinforcement Learning)
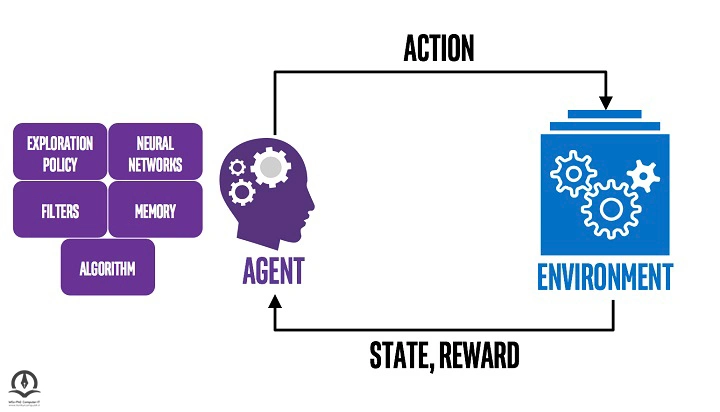
عامل در محیطهای پویا باید تصمیماتی براساس رویدادهای مختلف در محیط اتخاذ کند. در واقع عامل به کمک آزمون و خطا و دریافت بازخورد یاد میگیرد که چگونه تصمیم درست بگیرد. به این صورت که اگر عامل تصمیم نادرستی بگیرد، تنبیه میشود و اگر تصمیم درستی بگیرد پاداش دریافت میکند و این فرآیند به تقویت یادگیری عامل کمک میکند. برای درک بهتر، یادگیری عامل مانند کودکی است که اگر دستش را به جسم داغی بزند و دستش بسوزد متوجه میشود که جسم داغ است و دیگر دستش را به آن جسم نزدیک نمیکند؛ یا اگر کار خوبی کند و مورد تشویق دیگران قرار بگیرد، مجدداً آن کار را تکرار میکند. به علاقهمندان در حوزه یادگیری ماشین پیشنهاد میشود مقاله بهترین زبان برنامه نویسی برای یادگیری ماشین را مطالعه نمایند.
انواع الگوریتم های یادگیری ماشین
در این قسمت قصد داریم انواع الگوریتم های یادگیری ماشین را مورد بررسی قرار دهیم:
مدل رگرسیون خطی (Linear Regression)
رگرسیون خطی یکی از روشهای مهم در هوش مصنوعی و داده کاوی است که برای پیشبینی متغیرهای پیوسته به کار میرود. در این روش، یک رابطه خطی بین متغیرهای وابسته و مستقل تعریف میشود و با استفاده از دادههای آموزشی، پارامترهای این رابطه بهصورت خودکار تعیین میشوند. سپس با استفاده از این رابطه، مقدار متغیر وابسته برای دادههای جدید پیشبینی میشود. رگرسیون خطی بهعنوان یک روش ساده و قابل فهم برای پیشبینی و تحلیل دادهها در بسیاری از صنایع مورد استفاده قرار میگیرد.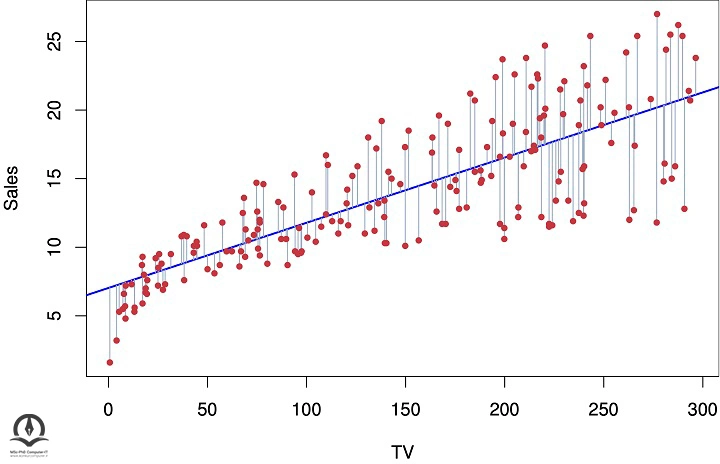
مدل رگرسیون لجستیک (Logistic Regression)
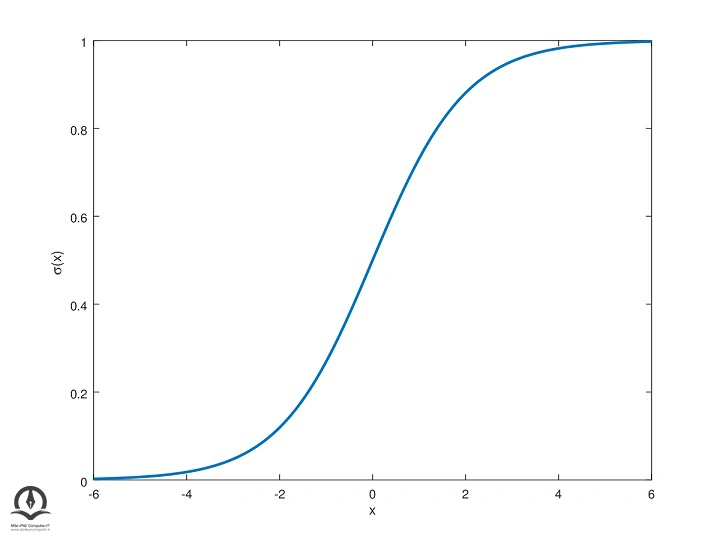
رگرسیون لجستیک نیز بهعنوان یک روش پرکاربرد در هوش مصنوعی و داده کاوی برای پیشبینی متغیرهای دودویی استفاده میشود. در این روش، یک رابطه خطی بین متغیرهای وابسته و مستقل تعریف میشود، اما با توجه به این که متغیر وابسته به صورت دودویی است، از تابع لجستیک (Sigmoid) برای تبدیل خروجی رگرسیون به مقادیر بین 0 و 1 استفاده میشود سپس با استفاده از این رابطه، احتمال متغیر وابسته برای دادههای جدید پیشبینی میشود.
مدل آنالیز تشخیص خطی (Linear Discriminant Analysis)
آنالیز تشخیص خطی نیز یک روش پرکاربرد در هوش مصنوعی و داده کاوی است که برای پیشبینی متغیرهای دودویی استفاده میشود. در این روش، یک تابع تصمیمگیری خطی برای جداسازی دو دسته از دادهها تعریف میشود. این تابع تصمیمگیری بهصورت یک ترکیب خطی از متغیرهای وابسته تعریف میشود و با استفاده از آن، دادهها به دو دسته جدا میشوند. سپس با استفاده از احتمالات پسین و با فرض توزیع نرمال برای هر دسته، احتمال متغیر وابسته برای دادههای جدید پیشبینی میشود.
مدل درخت تصمیم (Decision Tree)
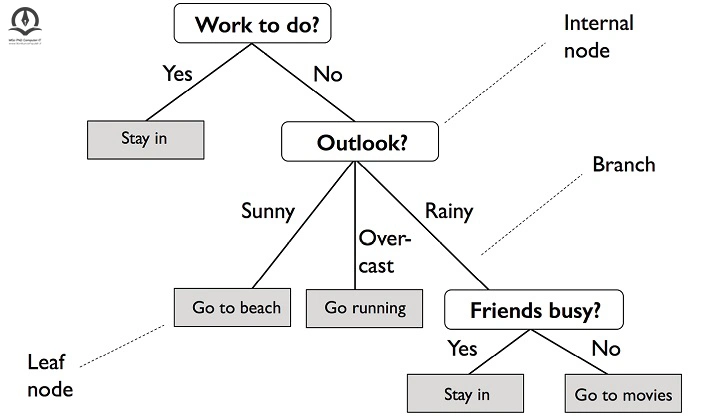
مدل درخت تصمیم یکی از روشهای پرکاربرد در هوش مصنوعی و داده کاوی برای پیشبینی متغیرهای دودویی و چندگانه است. در این روش، با استفاده از دادههای آموزشی، یک درخت تصمیم ساخته میشود که هر گره آن یک تصمیم برای جداسازی دادهها به دو گروه مختلف است. هر برگ درخت نشاندهنده یک دسته از دادههاست. سپس با استفاده از احتمالات پسین و با فرض توزیع نرمال برای هر دسته، احتمال متغیر وابسته برای دادههای جدید پیشبینی میشود. مزیت این روش قابل فهم بودن و قابل استفاده بودن برای دادههای غیر خطی است. در بازاریابی، میتوان از این روش برای تحلیل رفتار مشتریان و پیشبینی خرید آنها استفاده کرد.
مدل ماشین بردار پشتیبان (Support Vector Machine)
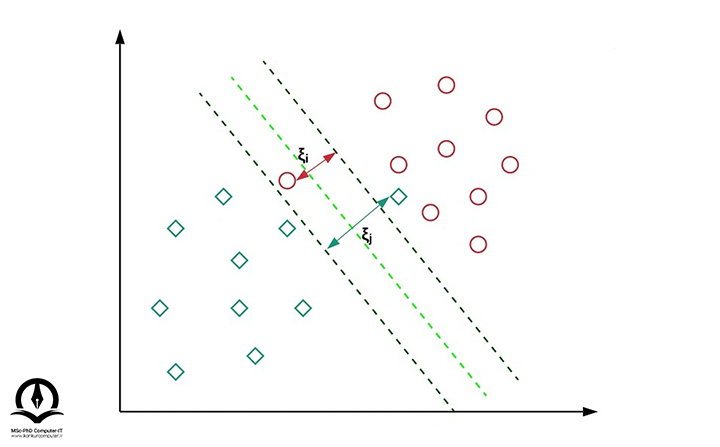
مدل ماشین بردار پشتیبان یا SVM یک روش پرکاربرد در هوش مصنوعی و داده کاوی برای پیشبینی متغیرهای دودویی و چندگانه است. در این روش، با استفاده از دادههای آموزشی، یک مرز تصمیم بین دو دسته از دادهها رسم میشود. این مرز تصمیم به گونهای تعیین میشود که فاصله بین نزدیکترین نقاط هر دو دسته بیشینه شود سپس با استفاده از احتمالات پسین و با فرض توزیع نرمال برای هر دسته، احتمال متغیر وابسته برای دادههای جدید پیشبینی میشود. یکی از مزیتهای این الگوریتم، این است که ماشین بردار پشتیبان در مواردی که تعداد نمونههای داده کم است، به خوبی عمل میکند و دقت پیشبینی بالایی دارد. از SVM میتوان در پردازش تصویر و تشخیص الگوهای خاص موجود در آنها استفاده کرد.
مدل بیز ساده (Naive Bayes)
در این روش، با استفاده از دادههای آموزشی، یک مدل احتمالاتی برای پیشبینی متغیر وابسته از متغیرهای مستقل ساخته میشود. مزیت این روش در مقایسه با روشهای دیگر، مانند ماشین بردار پشتیبان، سادگی و سرعت بالا در آموزش و پیشبینی است؛ همچنین، برای دادههای با ابعاد بالا و تعداد نمونههای کم، بهخوبی عمل میکند و دقت پیشبینی بالایی دارد. مدل بیز ساده در بسیاری از صنایع مورد استفاده قرار میگیرد، از جمله پردازش زبان طبیعی، تحلیل احساسات و غیره.
مدل K تا نزدیک ترین همسایه (K Nearest Neighbors) KNN
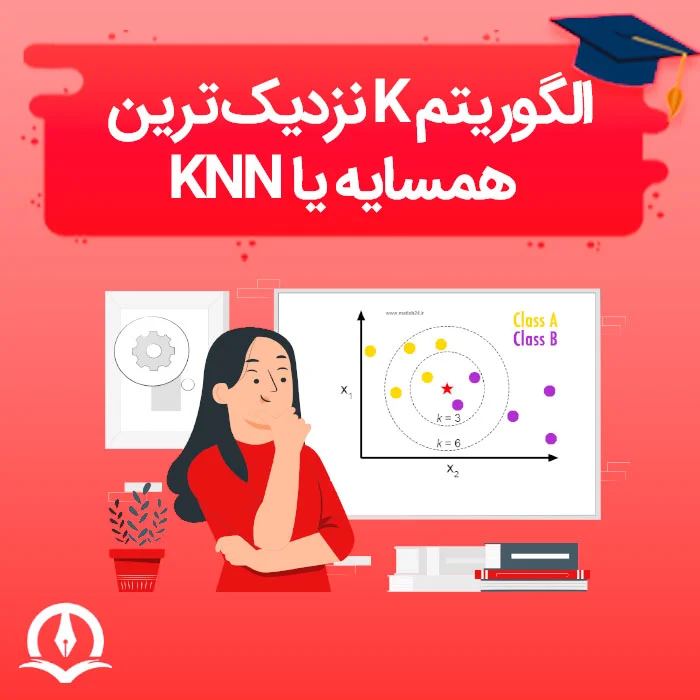
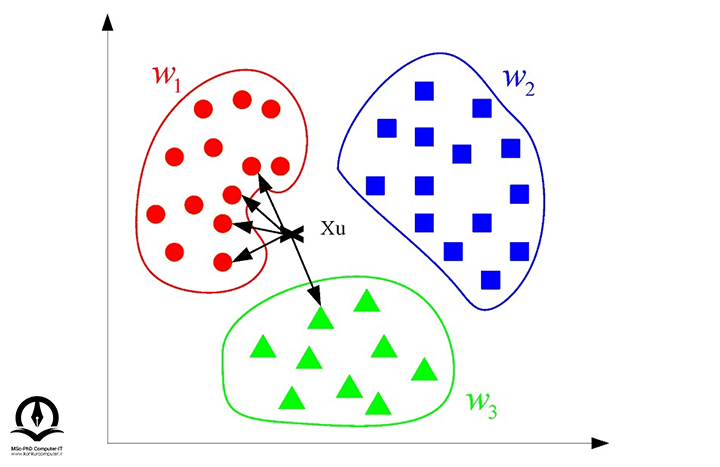
الگوریتم KNN یک الگوریتم یادگیری ماشین برای دستهبندی دادهها است. در این الگوریتم، برای دستهبندی هر نمونه، K نزدیکترین نمونه به آن انتخاب میشود و براساس بیشترین تعداد نمونههای هم دسته با آن نمونه، دستهبندی صورت میگیرد. این الگوریتم بهدلیل سادگی و قابلیت استفاده در مسائل پیشبینی و دستهبندی، بسیار محبوب است؛ همچنین، این الگوریتم برای دادههای با ابعاد بالا و تعداد نمونههای کم، بهخوبی عمل میکند و دقت پیشبینی بالایی دارد. در تحلیل دادههای فضایی، میتوان از این الگوریتم برای دستهبندی نقاط در فضای سه بعدی و یا بیشتر استفاده کرد.
مدل جنگل تصادفی (Random Forest)
الگوریتم جنگل تصادفی یک الگوریتم یادگیری ماشین برای دستهبندی و پیشبینی دادهها است که براساس ترکیب چندین درخت تصمیم گیری ایجاد میشود. هر درخت تصمیمگیری بهصورت تصادفی از بین ویژگیهای موجود انتخاب میکند و براساس آنها به دستهبندی نمونهها میپردازد سپس با محاسبه رای بیشترین دستهبندی شده توسط هر درخت، نمونهها به دستهبندی نهایی تقسیم میشوند. این الگوریتم قابل استفاده در مسائل با تعداد بالای ویژگیها و دادهها است.
مدل K-Means
یک الگوریتم خوشهبندی است که برای تقسیم دادهها به چند خوشه مختلف استفاده میشود. در این الگوریتم، ابتدا تعداد خوشههای مورد نظر تعیین میشود، سپس نمونهها بهصورت تصادفی در خوشههای مختلف قرار میگیرند و بعد با محاسبه مرکز هر خوشه و تخصیص هر نمونه به نزدیکترین مرکز خوشه، خوشهبندی نمونهها انجام میشود. در تحلیل دادههای بازاریابی، میتوان از این الگوریتم برای تقسیم مشتریان به چند گروه مختلف و برنامهریزی برای هر گروه استفاده کرد.
مدل Apriori
این مدل یک الگوریتم برای یادگیری ماشین بهروش انجمنی است که بالاتر به آن پرداخته شده است. با استفاده از این الگوریتم، میتوان الگوهای فراوان و رابطههای بین دادهها را استخراج کرد؛ بهطور مثال، اگر فردی گوشت قرمز و ماهی بخرد، ممکن است روغن مایع هم بخرد.
اگر شما هم اصطلاح یادگیری عمیق (Deep Learning) را، که امروزه جزو موارد داغ و کاربردی بهحساب میآید را شنیدید، حتما مقاله یادگیری عمیق (Deep Learning) را بررسی کنید.
جمعبندی
یادگیری ماشین یکی از زیرشاخه های علم هوش مصنوعی است که با توجه به مسائل مختلفی که وجود دارد، یادگیری ماشین هم به قسمتهای مختلفی تقسیم شده است. برای هر بخشی از یادگیری ماشین، الگوریتمهای خاص آن ارائه شده است بنابراین، انتخاب درست الگوریتم، به شناخت مسئله و مجموعه داده ما بسیار وابسته است. برنامه نویسان پایتون میتوانند از کتابخانه های پایتون مانند Scikit-Learn برای استفاده از الگوریتم های یادگیری ماشین، بهره ببرند، همچنین میتوانید مقاله یادگیری ماشین با پایتون را که مرتبط به این موضوع نیز میشود، مطالعه کنید.
کاربرد یادگیری ماشین چیست؟
کاربرد یادگیری ماشین در تحلیل دادههای مختلف از جمله پزشکی، مالی، ترافیک و... است. با استفاده از الگوریتمهای یادگیری ماشین، میتوان بهبود قابل توجهی در تحلیل دادهها و پیشبینی نتایج داشت.
چه تفاوتی بین یادگیری ماشین و یادگیری عمیق وجود دارد؟
یادگیری ماشین برای تحلیل دادهها و پیشبینی نتایج است ولی یادگیری عمیق زیرمجموعهای از یادگیری ماشین است و برای استخراج روابط دادههای پیچیدهتر و ساختارنیافته است.
چگونه میتوان دقت الگوریتم یادگیری ماشین را افزایش داد؟
با ایجاد تغییر در مجموعه داده و روند مدیریت دادههای گمشده، همچنین استخراج ویژگیهای مهم دادهها و تنظیم فراپارامترهای الگوریتم، میتوان دقت آن را بهبود داد.
مطالب مرتبط
همه مقالات