
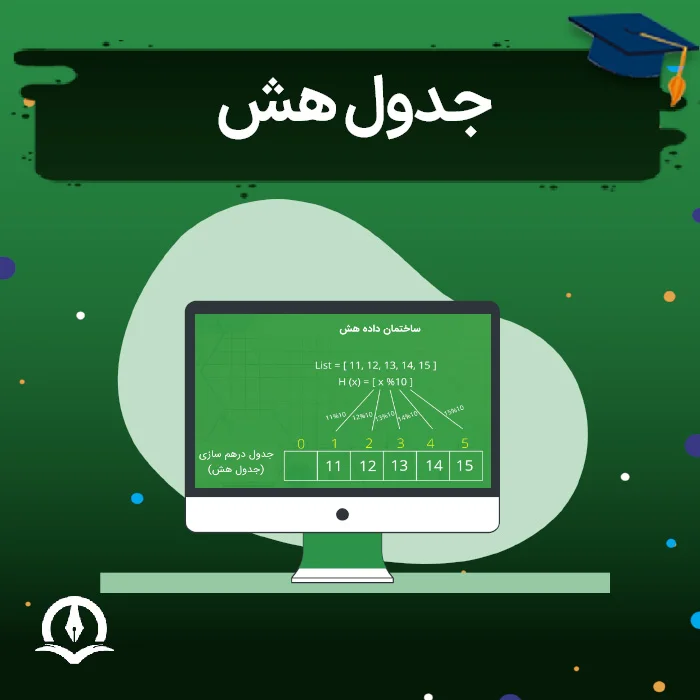
جدول هش یک ساختمان داده است که عناصر را در جفتهای کلید-مقدار ذخیره میکند، تعاریف کلید و مقدار در زیر آمده است:
- کلید: عدد صحیح منحصربهفرد که برای ذخیرهسازی مقادیر استفاده میشود.
- مقدار: دادههایی که با کلیدها مرتبط هستند.
در این مقاله به بررسی این ساختمان داده میپردازیم.
تابع Hash
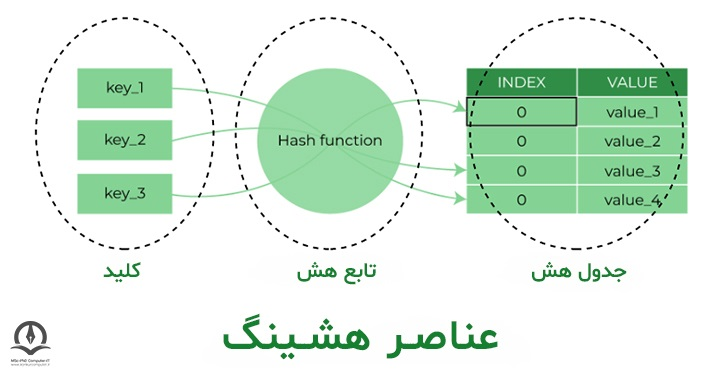
در یک جدول هش، یک شاخص جدید با استفاده از کلیدها پردازش میشود و عنصر مربوط به آن کلید در ایندکس ذخیره میشود. این فرآیند Hashing نامیده میشود. فرض کنید $\mathrm{k}$ یک کلید و $\mathrm{h}\left(\mathrm{x}\right)$ یک تابع هش باشد. در این جا، $\mathrm{h}\left(\mathrm{k}\right)$ یک شاخص جدید برای ذخیره عنصر مرتبط با $\mathrm{k}$ به ما میدهد. نحوه ذخیرهسازی این عناصر به شکل زیر است:
تصادم و روش های رفع آن
هنگامی که تابع هش یک شاخص یکسان را برای چندین کلید ایجاد میکند، یک تضاد وجود خواهد داشت (چه مقدار باید در آن شاخص ذخیره شود). این تضاد، تصادم هش نامیده میشود.
ما میتوانیم تصادم هش را با استفاده از یکی از تکنیکهای زیر حل کنیم:
- زنجیرهسازی
- آدرسدهی باز
زنجیره سازی
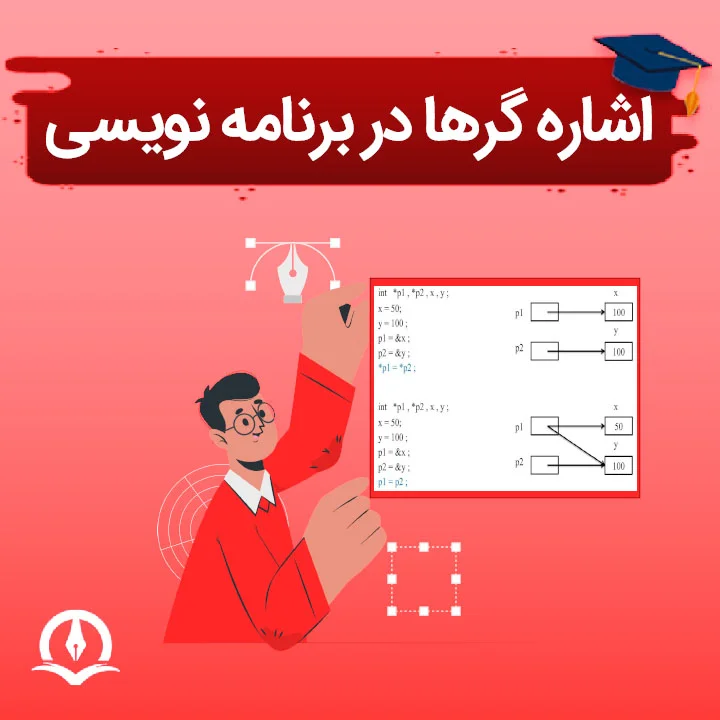
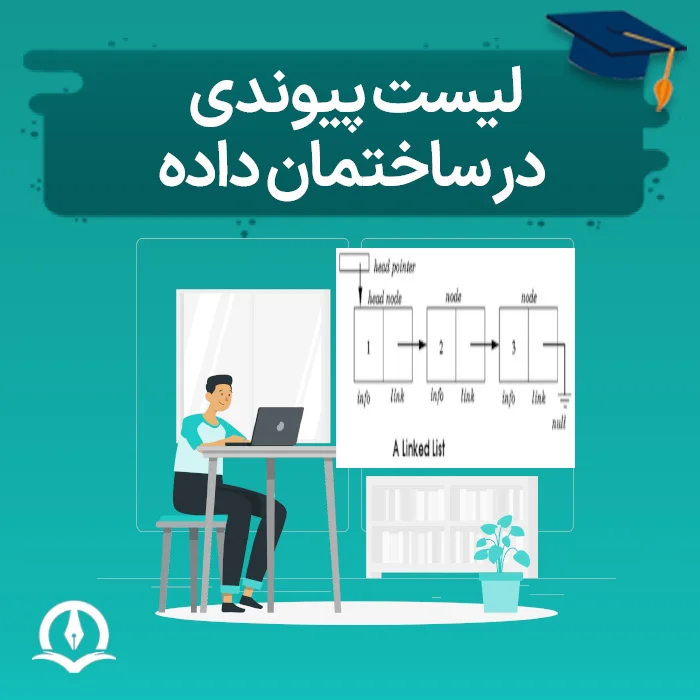
در زنجیرهسازی، اگر یک تابع هش، شاخص یکسانی را برای چندین عنصر تولید کند، این عناصر با استفاده از یک لیست پیوندی دوگانه در یک شاخص ذخیره میشوند. اگر $\mathrm{j}$ شاخصی برای چندین عنصر باشد، حاوی یک اشاره گر به سر لیست پیوندی عناصر است. اگر هیچ عنصری وجود نداشته باشد، $\mathrm{j}$ حاوی NIL است. شبه کد زیر نحوه پیادهسازی روش زنجیرهسازی را توضیح میدهد:
chainedHashSearch(T, k)
  return T[h(k)]
chainedHashInsert(T, x)
  T[h(x.key)] = x //insert at the head
chainedHashDelete(T, x)
  T[h(x.key)] = NIL
آدرس دهی باز
برخلاف زنجیرهسازی، آدرسدهی باز چندین عنصر را در یک خانه ذخیره نمیکند. در این جا، هر شاخص یا با یک کلید پر میشود یا با NIL. تکنیکهای مختلف مورد استفاده در آدرسدهی باز عبارتند از:
کاوش خطی
در کاوش خطی، برخورد با بررسی شکاف بعدی حل میشود.
$\mathrm{h}\left(\mathrm{k,}\mathrm{\textrm{i}}\right)\mathrm{=}\left({\mathrm{h}}^{\mathrm{'}}\left(\mathrm{k}\right)\mathrm{+}\mathrm{\textrm{i}}\right){\mathrm{mod} \mathrm{m}\ }$
که:
- $\mathrm{\textrm{i}}\mathrm{=}\left\{\mathrm{0,1,2,\dots }\right\}$
- ${\mathrm{h}}^{\mathrm{'}}\left(\mathrm{k}\right)$ یک تابع هش جدید است.
اگر برخوردی در $\mathrm{h}\left(\mathrm{k,0}\right)$ رخ دهد، سپس $\mathrm{h}\left(\mathrm{k,1}\right)$ بررسی میشود. به این ترتیب مقدار $\mathrm{\textrm{i}}$ به صورت خطی افزایش مییابد. مشکل کاوش خطی این است که یک خوشه از خانههای مجاور پر شده است. هنگام درج یک عنصر جدید، کل خوشه باید طی شود. این مسئله به زمان مورد نیاز برای انجام عملیات روی جدول هش میافزاید.
کاوش درجه دوم
این روش شبیه به کاوش خطی عمل میکند، اما فاصله بین خانهها با استفاده از رابطه زیر افزایش مییابد (بیشتر از یک):
$\mathrm{h}\left(\mathrm{k,}\mathrm{\textrm{i}}\right)\mathrm{=}\left({\mathrm{h}}^{\mathrm{'}}\left(\mathrm{k}\right)\mathrm{+}{\mathrm{c}}_{{\mathrm{1}}^{\mathrm{i}}}\mathrm{+}{\mathrm{c}}_{\mathrm{2}}{\mathrm{\textrm{i}}}^{\mathrm{2}}\right){\mathrm{mod} \mathrm{m}\ }$
که:
- ${\mathrm{c}}_{\mathrm{1}}$ و ${\mathrm{c}}_{\mathrm{2}}$ ثابتهای کمکی مثبت هستند.
- $\mathrm{\textrm{i}}\mathrm{=}\left\{\mathrm{0,1,\dots }\right\}$
هش دوبل
اگر پس از اعمال تابع هش $\mathrm{h}\left(\mathrm{k}\right)$ تصادمی رخ دهد، تابع هش دیگری برای یافتن خانه بعدی محاسبه میشود.
$\mathrm{h}\left(\mathrm{k,}\mathrm{\textrm{i}}\right)\mathrm{=}\left(\mathrm{h1}\left(\mathrm{k}\right)\mathrm{+ih2}\left(\mathrm{k}\right)\right){\mathrm{mod} \mathrm{m}\ }$
توابع هش مناسب
یک تابع هش خوب ممکن است به طور کامل از برخوردها جلوگیری نکند، اما میتواند تعداد برخوردها را کاهش دهد. در این جا ما به روشهای مختلف برای یافتن یک تابع هش خوب اشاره میکنیم:
روش تقسیم
اگر $\mathrm{k}$ یک کلید و $\mathrm{m}$ اندازه جدول هش باشد، تابع هش $\mathrm{h(\ )}$ به صورت زیر محاسبه میشود:
$\mathrm{h}\left(\mathrm{k}\right)\mathrm{=k}{\mathrm{mod} \mathrm{m}\ }$
به عنوان مثال، اگر اندازه یک جدول هش $\mathrm{10}$ و $\mathrm{k = 112}$ باشد، $\mathrm{h}\left(\mathrm{k}\right)\mathrm{= 112}{\mathrm{mod} \mathrm{10}\ }\mathrm{= 2}$. مقدار $\mathrm{m}$ نباید توانهای 2 باشد. این به این دلیل است که توانهای 2 در فرمت باینری هستند مانند 10، 100، 1000 و...، وقتی $\mathrm{k}{\mathrm{mod} \mathrm{m}\ }$ را پیدا می کنیم، همیشه P-Bit های کم ارزش را دریافت میکنیم.
اگر $\mathrm{m = 2^2}$ و $\mathrm{k=17}$، سپس $\mathrm{h}\left(\mathrm{k}\right)\mathrm{= 17}{\mathrm{mod} \mathrm{22}\ }\mathrm{= 10001}{\mathrm{mod} \mathrm{100}\ }\mathrm{= 01}$
اگر $\mathrm{m = 2^3}$ و $\mathrm{k=17}$، سپس $\mathrm{h}\left(\mathrm{k}\right)\mathrm{= 17}{\mathrm{mod} \mathrm{22}\ }\mathrm{= 10001}{\mathrm{mod} \mathrm{1000}\ }\mathrm{= 001}$
اگر $\mathrm{m = 2^4}$ و $\mathrm{k=17}$، سپس $\mathrm{h}\left(\mathrm{k}\right)\mathrm{= 17}{\mathrm{mod} \mathrm{22}\ }\mathrm{= 10001}{\mathrm{mod} \mathrm{10000}\ }\mathrm{= 0001}$
اگر $\mathrm{m = 2^p}$ و $\mathrm{h}\left(\mathrm{k}\right)\mathrm{= p}$ بیتهای کم ارزش $\mathrm{m}$
روش ضرب
$\mathrm{h}\left(\mathrm{k}\right)\mathrm{ = }\left\lfloor \mathrm{m}\left(\mathrm{kA}{\mathrm{mod} \mathrm{1}\ }\right)\right\rfloor$
که:
- $\mathrm{kA}{\mathrm{mod} \mathrm{1}\ }$ قسمت کسری $\mathrm{kA}$ را میدهد.
- $\mathrm{\lfloor }\mathrm{\ }\mathrm{\rfloor }$ مقدار کف را میدهد.
- $\mathrm{A}$ هر ثابتی است. مقدار $\mathrm{A}$ بین 0 و 1 قرار دارد. اما یک انتخاب بهینه $\mathrm{\approx}$ ($\mathrm{\sqrt{}}$5-1)/2 خواهد بود که توسط Knuth پیشنهاد شده است.
پیاده سازی جدول Hash
در ادامه پیاده سازی جدول Hash را در زبان های برنامه نویسی پایتون، جاوا، C و سی پلاس پلاس خواهیم دید.
Python
# Python program to demonstrate working of HashTable

hashTable = [[],] * 10

def checkPrime(n):
    if n == 1 or n == 0:
        return 0

    for i in range(2, n//2):
        if n % i == 0:
            return 0

    return 1


def getPrime(n):
    if n % 2 == 0:
        n = n + 1

    while not checkPrime(n):
        n += 2

    return n


def hashFunction(key):
    capacity = getPrime(10)
    return key % capacity


def insertData(key, data):
    index = hashFunction(key)
    hashTable[index] = [key, data]

def removeData(key):
    index = hashFunction(key)
    hashTable[index] = 0

insertData(123, "apple")
insertData(432, "mango")
insertData(213, "banana")
insertData(654, "guava")

print(hashTable)

removeData(123)

print(hashTable)
Java
// Java program to demonstrate working of HashTable

import java.util.*;

class HashTable {
  public static void main(String args[])
  {
  Hashtable<Integer, Integer>
    ht = new Hashtable<Integer, Integer>();

  ht.put(123, 432);
  ht.put(12, 2345);
  ht.put(15, 5643);
  ht.put(3, 321);

  ht.remove(12);

  System.out.println(ht);
  }
}
C
// Implementing hash table in C

#include <stdio.h>
#include <stdlib.h>

struct set
{
  int key;
  int data;
};
struct set *array;
int capacity = 10;
int size = 0;

int hashFunction(int key)
{
  return (key % capacity);
}
int checkPrime(int n)
{
  int i;
  if (n == 1 || n == 0)
  {
  return 0;
  }
  for (i = 2; i < n / 2; i++)
  {
  if (n % i == 0)
  {
    return 0;
  }
  }
  return 1;
}
int getPrime(int n)
{
  if (n % 2 == 0)
  {
  n++;
  }
  while (!checkPrime(n))
  {
  n += 2;
  }
  return n;
}
void init_array()
{
  capacity = getPrime(capacity);
  array = (struct set *)malloc(capacity * sizeof(struct set));
  for (int i = 0; i < capacity; i++)
  {
  array[i].key = 0;
  array[i].data = 0;
  }
}

void insert(int key, int data)
{
  int index = hashFunction(key);
  if (array[index].data == 0)
  {
  array[index].key = key;
  array[index].data = data;
  size++;
  printf("\n Key (%d) has been inserted \n", key);
  }
  else if (array[index].key == key)
  {
  array[index].data = data;
  }
  else
  {
  printf("\n Collision occured  \n");
  }
}

void remove_element(int key)
{
  int index = hashFunction(key);
  if (array[index].data == 0)
  {
  printf("\n This key does not exist \n");
  }
  else
  {
  array[index].key = 0;
  array[index].data = 0;
  size--;
  printf("\n Key (%d) has been removed \n", key);
  }
}
void display()
{
  int i;
  for (i = 0; i < capacity; i++)
  {
  if (array[i].data == 0)
  {
    printf("\n array[%d]: / ", i);
  }
  else
  {
    printf("\n key: %d array[%d]: %d \t", array[i].key, i, array[i].data);
  }
  }
}

int size_of_hashtable()
{
  return size;
}

int main()
{
  int choice, key, data, n;
  int c = 0;
  init_array();

  do
  {
  printf("1.Insert item in the Hash Table"
     "\n2.Remove item from the Hash Table"
     "\n3.Check the size of Hash Table"
     "\n4.Display a Hash Table"
     "\n\n Please enter your choice: ");

  scanf("%d", &choice);
  switch (choice)
  {
  case 1:

    printf("Enter key -:\t");
    scanf("%d", &key);
    printf("Enter data -:\t");
    scanf("%d", &data);
    insert(key, data);

    break;

  case 2:

    printf("Enter the key to delete-:");
    scanf("%d", &key);
    remove_element(key);

    break;

  case 3:

    n = size_of_hashtable();
    printf("Size of Hash Table is-:%d\n", n);

    break;

  case 4:

    display();

    break;

  default:

    printf("Invalid Input\n");
  }

  printf("\nDo you want to continue (press 1 for yes): ");
  scanf("%d", &c);

  } while (c == 1);
}
C++
// Implementing hash table in C++

#include <iostream>
#include <list>
using namespace std;

class HashTable
{
  int capacity;
  list<int> *table;

public:
  HashTable(int V);
  void insertItem(int key, int data);
  void deleteItem(int key);

  int checkPrime(int n)
  {
  int i;
  if (n == 1 || n == 0)
  {
    return 0;
  }
  for (i = 2; i < n / 2; i++)
  {
    if (n % i == 0)
    {
    return 0;
    }
  }
  return 1;
  }
  int getPrime(int n)
  {
  if (n % 2 == 0)
  {
    n++;
  }
  while (!checkPrime(n))
  {
    n += 2;
  }
  return n;
  }

  int hashFunction(int key)
  {
  return (key % capacity);
  }
  void displayHash();
};
HashTable::HashTable(int c)
{
  int size = getPrime(c);
  this->capacity = size;
  table = new list<int>[capacity];
}
void HashTable::insertItem(int key, int data)
{
  int index = hashFunction(key);
  table[index].push_back(data);
}

void HashTable::deleteItem(int key)
{
  int index = hashFunction(key);

  list<int>::iterator i;
  for (i = table[index].begin();
   i != table[index].end(); i++)
  {
  if (*i == key)
    break;
  }

  if (i != table[index].end())
  table[index].erase(i);
}

void HashTable::displayHash()
{
  for (int i = 0; i < capacity; i++)
  {
  cout << "table[" << i << "]";
  for (auto x : table[i])
    cout << " --> " << x;
  cout << endl;
  }
}

int main()
{
  int key[] = {231, 321, 212, 321, 433, 262};
  int data[] = {123, 432, 523, 43, 423, 111};
  int size = sizeof(key) / sizeof(key[0]);

  HashTable h(size);

  for (int i = 0; i < size; i++)
  h.insertItem(key[i], data[i]);

  h.deleteItem(12);
  h.displayHash();
}
کاربردهای جدول هش
جداول هش در جاهایی پیادهسازی میشوند که:
- آرایه های انجمنی: جداول هش معمولاً برای پیادهسازی انواع مختلفی از جداول در حافظه استفاده میشود. آنها برای پیادهسازی آرایههای انجمنی (آرایههایی که شاخصهای آنها، رشتههای دلخواه یا سایر اشیاء پیچیده هستند) استفاده میشوند.
- شاخص سازی پایگاه داده: جداول هش ممکن است به عنوان مبتنی بر دیسک و شاخصهای پایگاه داده (مانند DBM) نیز استفاده شوند.
- کش ها: جداول هش را می توان برای پیادهسازی کشها استفاده کرد، یعنی جداول دادههای کمکی که برای سرعت بخشیدن به دسترسی به دادهها استفاده میشوند، که در درجه اول در رسانههای کندتر ذخیره میشوند.
- نمایش شئ: چندین زبان پویا مانند Perl، پایتون، جاوا اسکریپت و روبی از جداول هش برای پیادهسازی اشیاء استفاده میکنند.
- استفاده در الگوریتم ها: از توابع هش در الگوریتمهای مختلف استفاده میشود تا محاسبات آنها سریعتر شود.
مزایا و معایب جدول هش
بزرگترین مزیت استفاده از جدول هش، جستجوی سریع در مقادیر زیاد داده است. با این حال، این امر معماران پایگاه داده را با چالش مواجه میکند که باید اندازه موردنیاز را از قبل تخمین بزنند تا خطر تصادم کم باشد. بسیاری از انواع دادهها را میتوان در جداول هش استفاده کرد تا زمانی که بتوان مقادیر هش را از آنها محاسبه کرد. از معایب جداول هش میتوان به این واقعیت اشاره کرد که پایگاه دادهها در صورت مواجهه با تعداد زیادی تصادم، میتوانند تخریب شوند. احتمال وقوع تصادم با افزایش مقدار دادهها، افزایش مییابد. تعداد زیادی از توابع هش، توانایی انتقال به مجموعه دادههای بعدی یا قبلی را ندارند.
جمعبندی
در این مقاله به بررسی جدول Hash پرداختیم. از معرفی این ساختمان داده شروع کردیم و سپس تصادم و انواع روشهای آنرا بررسی کردیم و همچنین نحوه پیادهسازی این ساختمان داده در زبانهای برنامه نویسی مختلف را دیدیم و در نهایت به کاربردهای آن اشاره کردیم.
تفاوت Hash Map و Hash Table چیست؟
Hash Map اجازه یک کلید تهی و چندین مقدار تهی را میدهد، در حالی که Hash Table هیچ کلید یا مقدار تهی را مجاز نمیکند. در صورتی که نیازی به همگامسازی رشته نباشد، Hash Map به طور کلی بر Hash Table ترجیح داده میشود.
آیا دیکشنری پایتون یک جدول هش است؟
دیکشنریها در پایتون با استفاده از جداول هش پیادهسازی میشوند. دیکشنری، آرایهای است که شاخصهای آن با استفاده از تابع هش روی کلیدها به دست میآید.
کاربرد روزمره جدول هش چیست؟
جداول هش به ما امکان میدهند چیزهایی مانند دفترچه تلفن یا فرهنگ لغت را پیادهسازی کنیم. در آنها، ما ارتباط بین یک مقدار (مانند تعریف فرهنگ لغت کلمه "لامپ") و کلید آن (خود کلمه "لامپ") را ذخیره میکنیم. میتوانیم از جدولهای هش برای ذخیره، بازیابی و حذف دادهها به طور منحصربهفرد بر اساس کلید منحصربهفرد آنها استفاده کنیم.